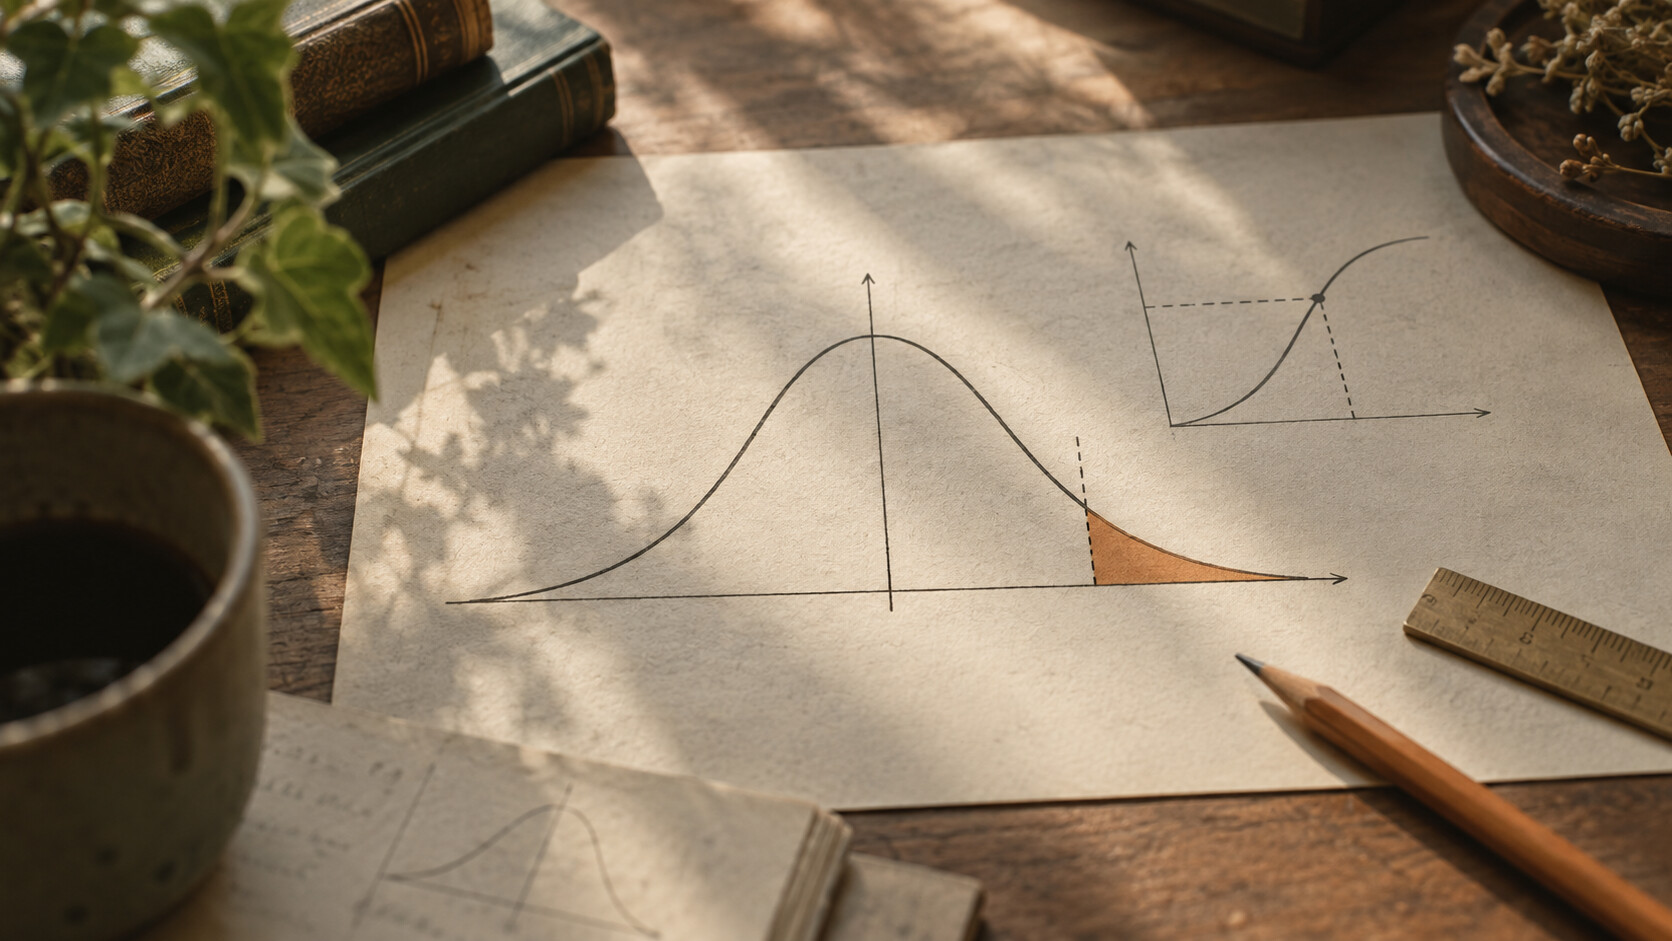
P-value 和 Quantile Function(分位数函数)经常一起出现在假设检验里,但它们不是同一个量。它们读取的是同一条原假设分布,只是方向相反:p-value 把观测到的统计量变成尾部概率;quantile function 把概率水平变成临界值。
如果想先看一眼可拖动的标准正态分布演示,可以打开交互版页面。本文则把它们之间的数学关系完整写下来。
先说结论:一个负责报告,一个负责设线
设检验统计量为 $T$,在原假设 $H_0$ 下的累积分布函数为 $F_0$,观测到的统计量为 $t_{\text{obs}}$。
在右尾检验中,p-value 是:
$$ p = P_0(T \ge t_{\text{obs}}) = 1 - F_0(t_{\text{obs}}) $$
它回答的是:假设 $H_0$ 成立时,出现同样或更极端结果的概率有多大?
而 Quantile Function 是 CDF 的反向操作。定义
$$ Q_0(u) = F_0^{-1}(u) $$
给定一个概率 $u$,它返回原假设分布中对应的分位点。于是,右尾检验在显著性水平 $\alpha$ 下的临界值是:
$$ c_\alpha = Q_0(1 - \alpha) $$
它回答的是:为了让右侧拒绝域只占 $\alpha$ 的面积,统计量要大到哪里?
所以,在连续分布且检验方向一致时,两种判定写法是等价的:
$$ p < \alpha \quad\Longleftrightarrow\quad t_{\text{obs}} > Q_0(1 - \alpha) $$
这不是说“p-value 等于 quantile function”,而是说:它们是同一个拒绝规则的两种坐标。
第一张地图:p-value 从数值走向概率
CDF 先告诉你左侧积了多少面积
累积分布函数 $F_0(t)$ 的含义是:
$$ F_0(t) = P_0(T \le t) $$
它把横轴上的一个数值 $t$,映射成左侧累计概率。
如果备择假设认为统计量应该更大,也就是右尾检验,就看右侧剩余面积:
$$ p_{\text{right}} = 1 - F_0(t_{\text{obs}}) $$
如果备择假设认为统计量应该更小,也就是左尾检验,则直接看左侧面积:
$$ p_{\text{left}} = F_0(t_{\text{obs}}) $$
例如,在标准正态分布下,观测到 $z=1.96$:
- 右尾 p-value 约为 $0.025$;
- 如果做对称的双侧检验,p-value 约为 $2 \times 0.025 = 0.05$。
观测值越远离分布中心,尾部面积越小,p-value 也越小。
第二张地图:Quantile Function 从概率走向边界
Quantile Function 的方向刚好相反:你不再从一个观测值出发,而是先给出一个概率水平,再找对应的横坐标。
对于连续且严格单调的 CDF,可以直观地写成:
$$ Q_0(u) = x \quad\text{when}\quad F_0(x)=u $$
更一般地,分位数使用广义逆函数:
$$ Q_0(u)=\inf{x:F_0(x)\ge u} $$
这一定义也能处理 CDF 不连续或有平台的情况。
在标准正态分布里:
- $Q(0.95) \approx 1.645$,对应右尾 $5%$ 的临界值;
- $Q(0.975) \approx 1.960$,对应双侧总计 $5%$ 时的正侧临界值。
因此,quantile function 并不是在告诉你“这次数据的 p-value 是多少”,而是在帮你提前画出拒绝域的边界。
把三种检验方向放在一张表里
记 $t_{\text{obs}}$ 为观测统计量,$F_0$ 为原假设下的 CDF,$Q_0$ 为其分位数函数。
| 检验方向 | p-value:统计量 → 概率 | 临界值:概率 → 统计量 |
|---|---|---|
| 右尾:$H_1$ 更大 | $P_0(T\ge t_{\text{obs}})=1-F_0(t_{\text{obs}})$ | $c_\alpha=Q_0(1-\alpha)$ |
| 左尾:$H_1$ 更小 | $P_0(T\le t_{\text{obs}})=F_0(t_{\text{obs}})$ | $c_\alpha=Q_0(\alpha)$ |
| 双侧:$H_1$ 不相等 | 对称分布时:$2[1-F_0( | t_{\text{obs}} |
最值得记住的是第三列:显著性水平决定尾部预算,分位数函数把预算换成临界值。
为什么 p-value 小,就等价于越过临界值?
以右尾检验为例。p-value 小于 $\alpha$ 意味着:
$$ 1-F_0(t_{\text{obs}})<\alpha $$
移项得到:
$$ F_0(t_{\text{obs}})>1-\alpha $$
再对 CDF 做反向映射,就得到:
$$ t_{\text{obs}}>Q_0(1-\alpha) $$
左边是“从数据出发算 p-value”,右边是“先用 $\alpha$ 设定拒绝边界”。在连续分布中,它们只是在同一条曲线上从两端描述同一件事。
这也解释了统计软件里经常同时出现的两个函数:
cdf(x):给定 $x$,返回左侧累计概率;ppf(q)或quantile(q):给定 $q$,返回对应的分位点。
三个容易踩的坑
1. p-value 不是“原假设为真的概率”
p-value 的条件是 $H_0$ 已经被当作计算前提。它表达的是:
$$ P(\text{数据同样或更极端}\mid H_0\text{成立}) $$
而不是:
$$ P(H_0\text{成立}\mid\text{数据}) $$
这两个条件概率方向相反,不能直接互换。
2. $\alpha$ 不是看完数据后再挑的数字
$\alpha$ 是决策规则的一部分,通常应在观察数据之前设定。p-value 是数据到来后计算出来的证据强度;把“我想要显著”当成标准,再反过来挑一个合适的 $\alpha$,会改变原本的错误率控制。
3. 双侧 p-value 不能机械地永远乘 2
对于对称的 z/t 类统计量,$2[1-F_0(|t_{\text{obs}}|)]$ 是常见写法。但一般情况下,“更极端”可能不是简单地把两侧面积相加:它取决于统计量的分布、对称性以及检验的定义。
如果统计量是离散的,CDF 还会出现跳跃,分位数需要用广义逆函数;这时 p-value 与“恰好等于 $\alpha$”的临界值规则之间,也可能出现不等号或保守性。
最后记成一句话
CDF 把数值映射成概率,Quantile Function 把概率映射回数值。
p-value 是“数据落在尾部的面积”,用于报告观测结果有多极端;quantile function 是“根据尾部预算找出的横坐标”,用于设置拒绝域的临界值。
所以它们不是相等关系,而是一对反向的操作:
$$ \text{观测统计量} \xrightarrow{;F_0\text{ / survival};} \text{尾部概率} $$
$$ \text{概率水平} \xrightarrow{;Q_0=F_0^{-1};} \text{临界值} $$
真正要记住的不是某个软件函数名,而是方向:p-value 负责衡量,quantile function 负责设线。